専門家による調査: ニューラル ネットのロールアウト、エラー分類、ディープ タイミング
競技プレイヤー向けの信頼できるガイド: ニューラル エンジンのアーキテクチャ、ロールアウト信頼区間と標準誤差の理解、失敗と戦略上の不正確さの分類、およびパフォーマンス レーティング (PR) 指標。
Interactive Position & Tactical Setup
ダブリングキューブの判断局面
Assessing the Take-Point Threshold (145 vs 177 Pips)
Strategic Insight & Key Lesson
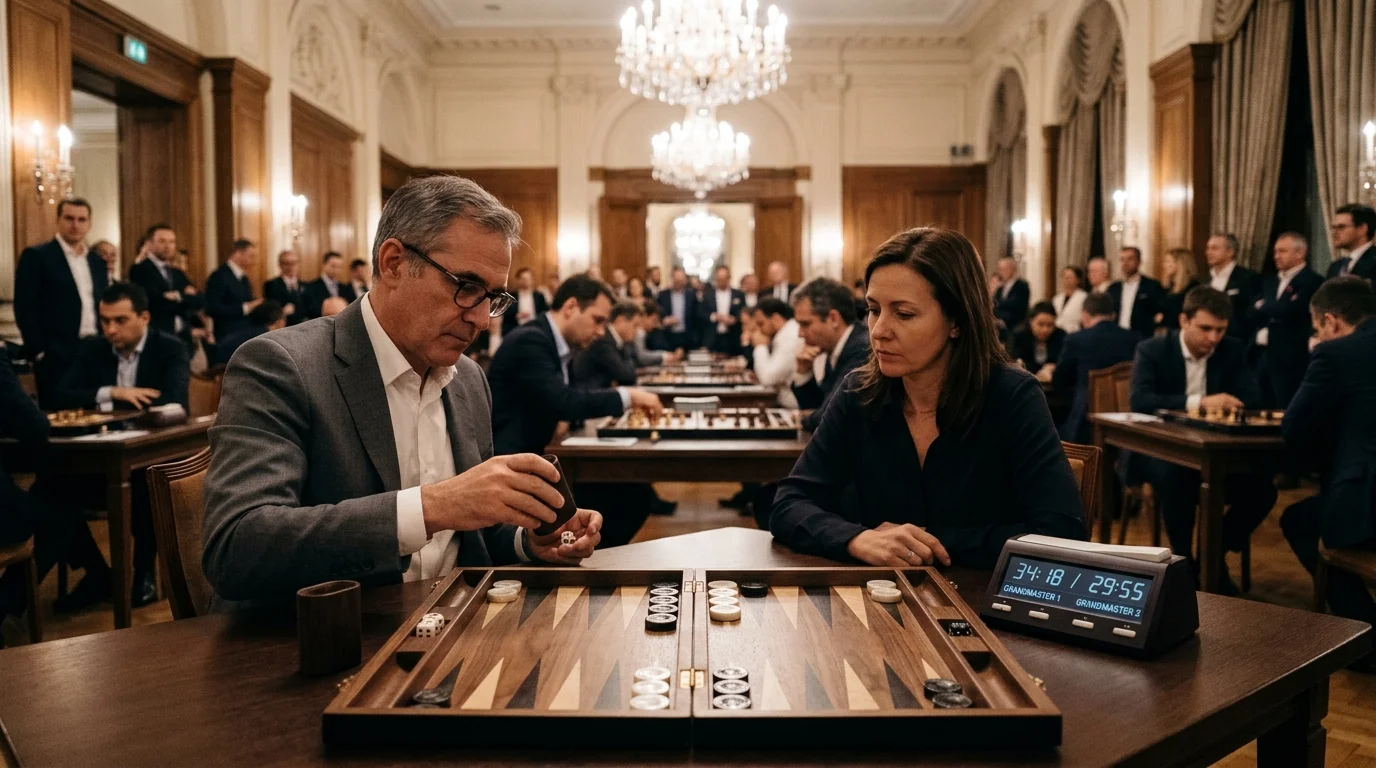
A pivotal mid-game cube decision where Player 1 has doubled. Player 2 must evaluate winning probability against the take-point threshold, weighing gammon risks and live cube option equity.
Key Strategic Takeaways
- ニューラル評価エンジンは、セルフプレイ強化学習で訓練された多層ネットワークを介してバックギャモンを評価します。
- 「プライ」は 1 ターンの先読みです。0 プライは静的な重みを評価します。 2 層では 36 個の応答すべてが評価されます。ロールアウトでは、1,296 以上のゲーム全体が完了するまでシミュレートされます。
- プルーニングヒューリスティックによりバイアスが生じる可能性があるため、長いロールアウトを行わない 2 プライの小さな評価差 (< 0.015 エクイティ) を決して信頼しないでください。
- パフォーマンス レーティング (PR) は、判定ごとに失われた資産の合計を測定します。3.5 未満の PR は、世界クラスのチャンピオンシップの実力を示します。
- 戦術/計算のエラー (ダイレクトショットのミス) と戦略/評価のエラー (間違ったゲームプラン) を区別します。
ニューラル エンジン革命: 最新のソフトウェアによるポジションの評価方法
1990 年代初頭まで、バックギャモン戦略は人間の教義と口頭伝承によって支配されていました。それは、超人的なバックギャモンの熟練度を達成した初の強化学習ニューラル ネットワークである、ジェラルド テサウロ博士の TD-Gammon によって変わりました。
最新のゴールドスタンダード ニューラル ネットワーク エンジンは、チェッカーの分布、ボードの接続性、アンカーの深さ、および接触確率を表す何百万ものノードの重みを評価します。
評価の深さ: 0 層、2 層、3 層、およびロールアウト
バックギャモン ソフトウェアを使用して学習する場合、評価の深さを理解することが重要です。
• 0-Ply (静的評価): エンジンは、先を読むことなく、静的なボード座標をニューラル ネットワークに入力します。非常に速いが、巧妙な戦術的な罠には気付かない。
• 2 プライ (先読み): エンジンはすべての正当な候補プレイを計算し、1 ターン全体を先読みします (対戦相手の 36 個のサイコロの出目をすべて調べます)。これは、高速一致分析のための標準エンジン設定です。
• 3-Ply / 4-Ply: アルファ-ベータ枝刈りにより、複数のターンにわたって先読みを拡張します。複雑なプライミング戦闘に高い精度を発揮します。
• ロールアウト (モンテカルロ シミュレーション): 議論の余地のないグラウンド トゥルース。エンジンは、すべてのゲームが勝利、ギャモン、または譲歩で終了するまで、2 プライまたは 3 プライの選択肢を使用して、正確な位置を何百回または何千回 (通常は 1,296 回または 3,600 回の試行) 実行します。
すべてのロールアウトには標準誤差が表示されます (例: 資本: +0.420 ± 0.012)。 2 つの候補手の差異が標準誤差の 2 倍未満である場合、エンジンはどちらのプレイが優れているかを数学的に証明していません。ロールアウトの微細な違いにこだわる必要はありません。
エラーの分類とパフォーマンス評価 (PR) 式
最新の競争トーナメント分析では、標準化されたしきい値を使用して、正規化された資本損失 (ミリポイント) ごとに決定を分類します。
• 疑わしい / 不正確: 株式損失は 0.020 ~ 0.039 です。
• 不良/エラー: 0.040 ~ 0.079 の株式損失。
• 非常に悪い / 不手際: 0.080 以上の株式損失。
パフォーマンス評価 (PR) 指標: 国際連盟 (WBGF、USBGF) によって標準化されており、PR は決定ごとに失われる非強制資本の平均を 500 でスケールしたものです。
| PR範囲 | スキルレベルの指定 | 平均株式損失/決定 | 選手の特徴 |
|---|---|---|---|
| 0.00~2.99 | 世界クラスの巨人/エリート | 決定ごとに < 0.006 | めったに失敗はしません。ほぼ完璧なキューブ処理と詳細な計算 |
| 3.00 – 4.99 | マスター / トップコンペティター | 決定ごとに 0.006 – 0.010 | 一貫したトーナメント出場者。すべてのプランにわたる健全な基本 |
| 5.00 – 7.99 | 上級エキスパート | 決定ごとに 0.010 – 0.016 | 力強いオープニングとレーシング。時折発生する複雑なキューブまたは遅延アンカー エラー |
| 8:00 – 11:99 | 中級クラブプレーヤー | 決定ごとに 0.016 ~ 0.024 | 健全な基本的なルール。頻繁なアンカーリリースとタイミングミス |
| 12.00+ | カジュアル / 初心者向け | 決定ごとに > 0.024 | 受動的にプレーします。誤審によりキューブの賭け金とギャモンのリスクが倍増する |
位置的犠牲と深いタイミングの戦い
エキスパートレベルでは、ゲームは直感に反する位置的犠牲によって勝利します。
• 「再循環」: 相手のホームボードに意図的にブロットを残して攻撃します。なぜ?バックゲームやホールディングゲームを実行しているときは、前軍の攻撃を遅らせるために合計に追加のピップを追加する必要があります。再循環チェッカーにより失われたタイミングが回復します。
• 「脅威下での高地点のクリア」: 攻撃を受けている高度なポイントを解体すると、クリアを遅らせると次のターンに 2 倍のリターンショットが残るためです。
対戦相手の調整: 人間の逸脱を利用する
ゲーム理論最適化 (GTO) プレイでは完璧なマシンに対する公平性が最大化されますが、トーナメントの競争では人間による微妙な調整が報われることがよくあります。
• 臆病なドロッパー: 対戦相手が恐怖から勝利エクイティ 28% で常にダブルパスをパスする場合は、GTO の規定よりも早くダブルを行います。コンピュータが取るポジションのキャッシュポイント。
• 無謀なテイカー: 対戦相手がキューブを落とさない場合は、倍増ウィンドウを締めます。投機的なポジションを二重にしないでください。アドバンテージが完全になくなるまで待って、ポイントまたはギャモンを全額現金化してください。
Tactical Check: Test Your Comprehension
Select candidate plays and verify your tactical reasoning against engine rollout analysis.